Компанія TypeSafe AI випустила модель, яка не робить того, що зробило ChatGPT, Claude чи Gemini популярними, — вона взагалі не пише текст. Замість цього Jev дає готове рішення з оцінкою ймовірності: за 70–500 мілісекунд і в сотні разів дешевше за звичайну мовну модель.
Розбираємо, що таке модель класу System One, чим вона відрізняється від LLM на кшталт GPT і де вже застосовується на практиці.

Що таке Jev і що її вирізняє
Модель Jev розробила команда TypeSafe AI із Сан-Франциско. Два роки компанія працювала над проєктом таємно, не розповідаючи про нього публічно, і за цей час створила власний спосіб побудови моделі та новий метод її навчання під назвою Reinforcement Learning for Calibrated Decisions (RLCD) — він відповідає за те, щоб модель не просто вгадувала відповідь, а давала реалістичну оцінку того, наскільки вона в ній впевнена.
Проєкт представили 15 вересня 2026 року. Одночасно компанія залучила $40 млн інвестицій — цей раунд очолив фонд DCVC.
TypeSafe не називає Jev меншою чи спрощеною версією звичної мовної моделі — на кшталт GPT. Компанія стверджує, що це зовсім інший тип моделі, і називає його «System One».
Назва походить від психолога Деніела Канемана, який розділив людське мислення на два режими. Перший — швидкий, інтуїтивний: миттєва реакція без роздумів, наприклад коли ви одразу розумієте, що щось термінове, ще не встигнувши це усвідомити. Другий — повільний, свідомий: коли ви зважуєте аргументи і формулюєте розгорнуту відповідь.
Логіка TypeSafe у тому, що більшість рішень усередині програм — це не складні роздуми, а швидкі судження на кшталт «до якої категорії це належить» чи «наскільки це термінове». Раніше для таких простих рішень доводилося щоразу запускати потужну модель, яка вміє вести розгорнуту розмову й писати тексти, — хоча для швидкого судження вся ця потужність не потрібна.
У чому відмінність Jev від LLM і GPT
Головна відмінність — у тому, що модель видає на виході.
Мовна модель на кшталт GPT формує текстом. Спочатку вона пише одне слово, тоді наступне, і так по черзі, поки не сформує повне речення. Потім цей текст потрібно прочитати й перевірити: чи не написала модель зайвого, чи не помилилась, чи взагалі відповідь у тому форматі, який очікувався.
Jev працює інакше. Замість тексту вона одразу видає готову відповідь у чіткому форматі — наприклад, обраний варіант із заданого списку та ймовірність, наскільки він правильний. Нічого читати й перевіряти не потрібно: відповідь одразу в потрібному вигляді, і помилок формату в ній просто не буває.
Є ще відмінності:
- швидкість: Jev відповідає за 70–500 мілісекунд, тоді як мовній моделі на розгорнуту відповідь потрібні секунди;
- впевненість: коли Jev каже, що впевнена у відповіді на 90%, це справді означає високу ймовірність правильності. У звичних мовних моделей впевненість часто буває завищеною — вони можуть звучати переконливо навіть тоді, коли помиляються.
При цьому Jev так само розуміє звичайну мову на вході, як і GPT. Різниця тільки в тому, що вона видає на виході: не текст, а готове рішення.
Як влаштована модель технічно
У Jev можна ставити лише три типи питань.
- Вибір із варіантів (choice). Ви даєте моделі список можливих відповідей — до 255 — і вона обирає одну з них. Наприклад: «до якого відділу віднести це звернення: продажі, підтримка чи бухгалтерія». У відповідь модель повертає не тільки обраний варіант, а й ймовірність для кожного з них та те, наскільки вона впевнена у своєму виборі.
- Оцінка за шкалою (score). Ви словами описуєте шкалу — наприклад, від 1 до 10, де 1 означає «клієнт спокійний», а 10 — «клієнт дуже роздратований» — і модель ставить оцінку. Ця оцінка може бути й дробовою, наприклад 6,4, якщо ситуація не вписується точно в жоден рівень.
- Питання «так чи ні» (noul). Модель відповідає не просто «так» або «ні», а дає ймовірність від 0 до 1 — наприклад, 0,85 означатиме «швидше так, з високою ймовірністю».
Якщо варіантів вибору більше за 255, модель працює у два кроки: спочатку оцінює кожного кандидата окремо, а потім обирає одного з них.
Усі питання в одному запиті модель обробляє одночасно, а не по черзі. Тому якщо запитати не одне, а десять питань одразу — швидкість відповіді майже не зміниться.
Модель Jev навчали так, щоб її впевненість у відповіді відповідала реальній точності: якщо вона каже, що впевнена на 90%, то приблизно в 9 випадках із 10 вона справді має рацію.
Для чого використовувати Jev — у яких процесах вона корисна
Jev підходить для завдань, де потрібно часто ухвалювати однотипні рішення з наперед відомим набором відповідей: розподіляти звернення підтримки за відділами, визначати, чого хоче користувач, модерувати контент, витягувати дані з тексту чи перевіряти результати роботи інших моделей.
Наприклад боту у грі Minecraft постійно передавали опис поточної ситуації: час доби, вороги поруч, скільки здоров’я лишилось, які дії доступні. На основі цього Jev обирала, що робити далі. Коли вночі зʼявлялися зомбі, бот тікав — хоча правило «тікай від зомбі» ніхто окремо не прописував. Поведінка формувалася сама собою, бо модель просто постійно запитували: що робити в цій ситуації. Двохвилинна така сесія коштувала близько 1 цента.
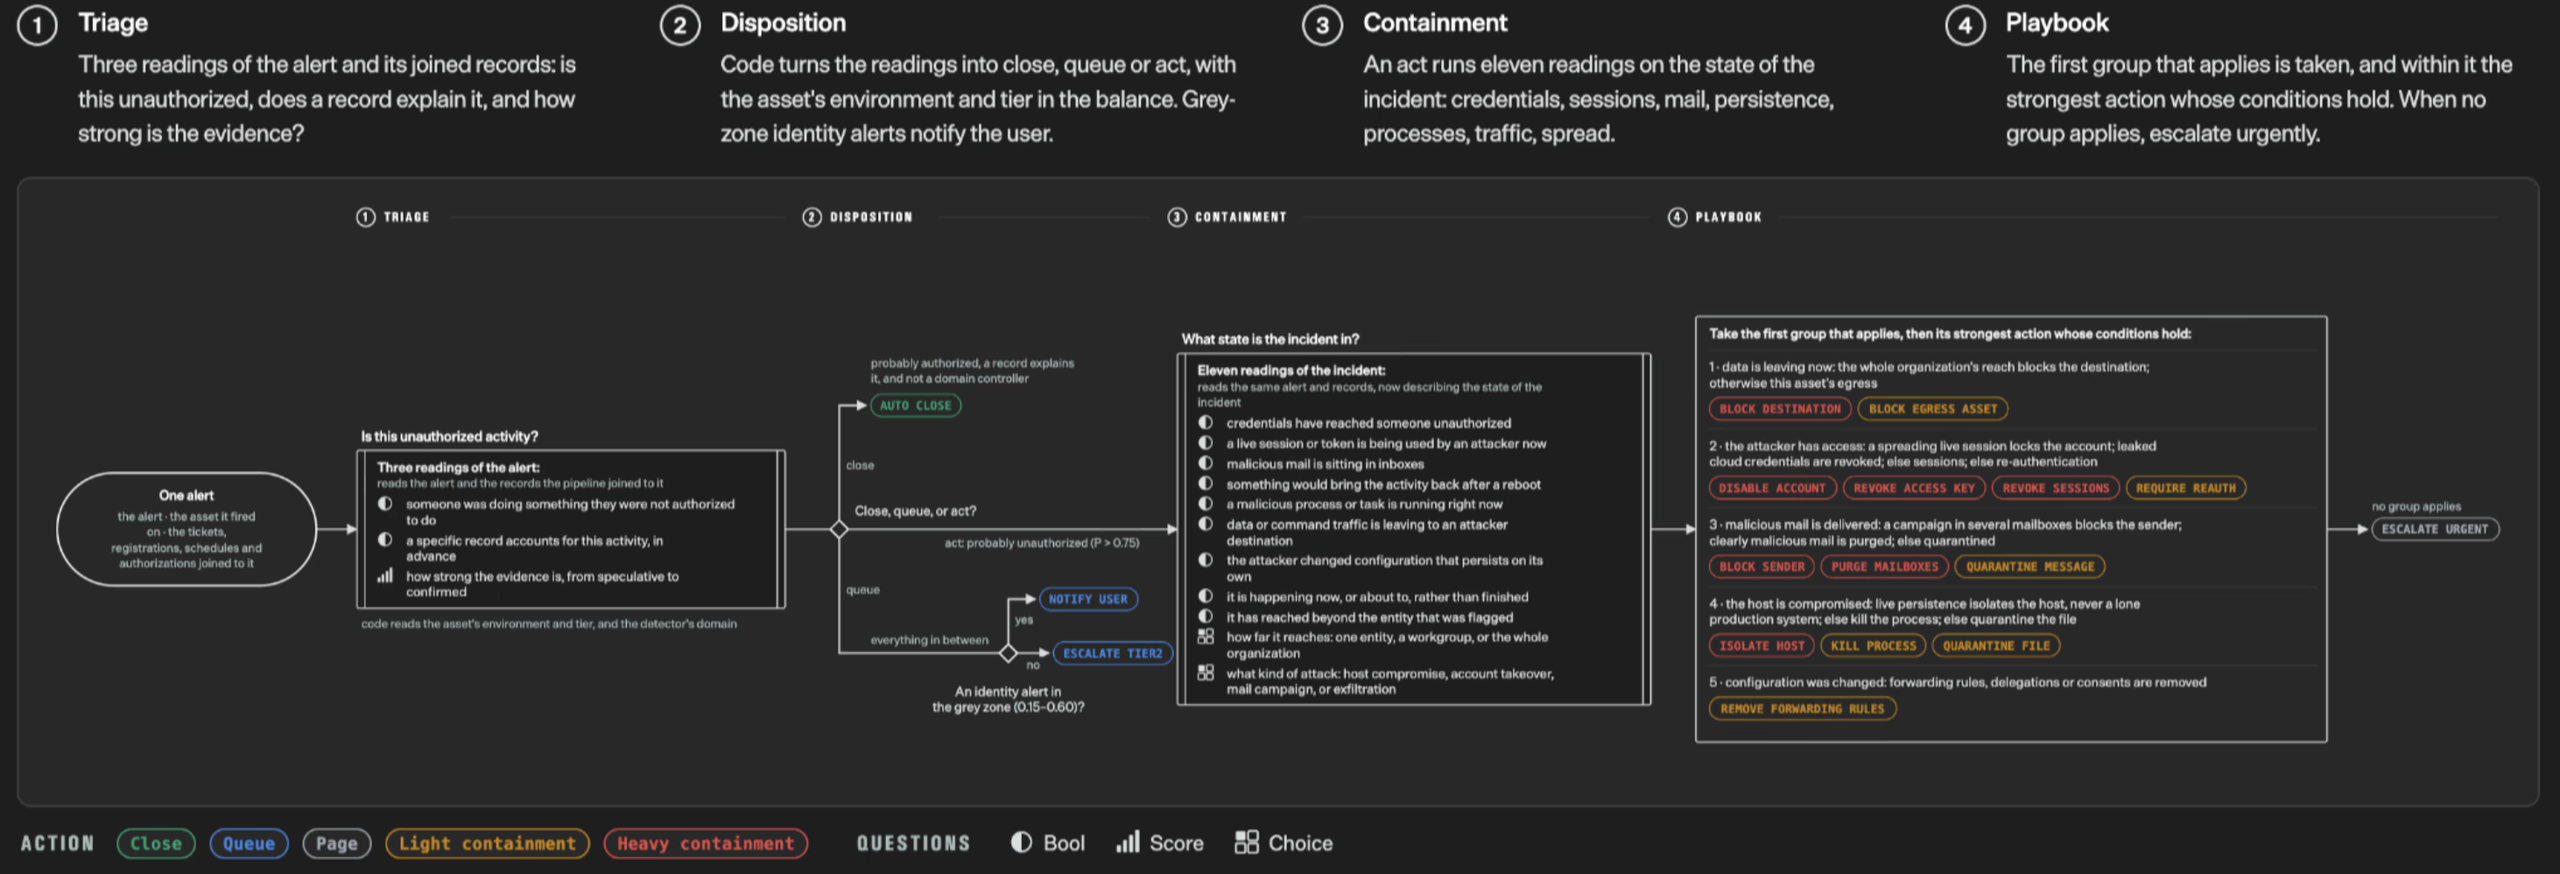
У реальних проєктах Jev зазвичай не працює сама, а є однією з ланок у більшій системі. Типова схема — конвеєр з трьох рівнів: Jev швидко й дешево сортує запити, звичайний програмний код обробляє прості випадки за жорсткими правилами, а повноцінна мовна модель береться лише за складні винятки.
Розробники також налаштовують систему за рівнем довіри: для кожної дії задають свій поріг ризику. Якщо Jev впевнена у відповіді — система діє автоматично. Якщо впевненість середня — система спершу запитує підтвердження. Якщо впевненість низька — рішення передають людині або повноцінній мовній моделі.
Швидкість, вартість і застереження
TypeSafe заявляє про те, що відповідь займає від 70 до 500 мілісекунд, вхідні токени коштують $0,042 за мільйон, а вивід — безкоштовний. За власним тестуванням компанії, модель швидша за звичайні LLM у 193,6 раза і дешевша у 444,6 раза.
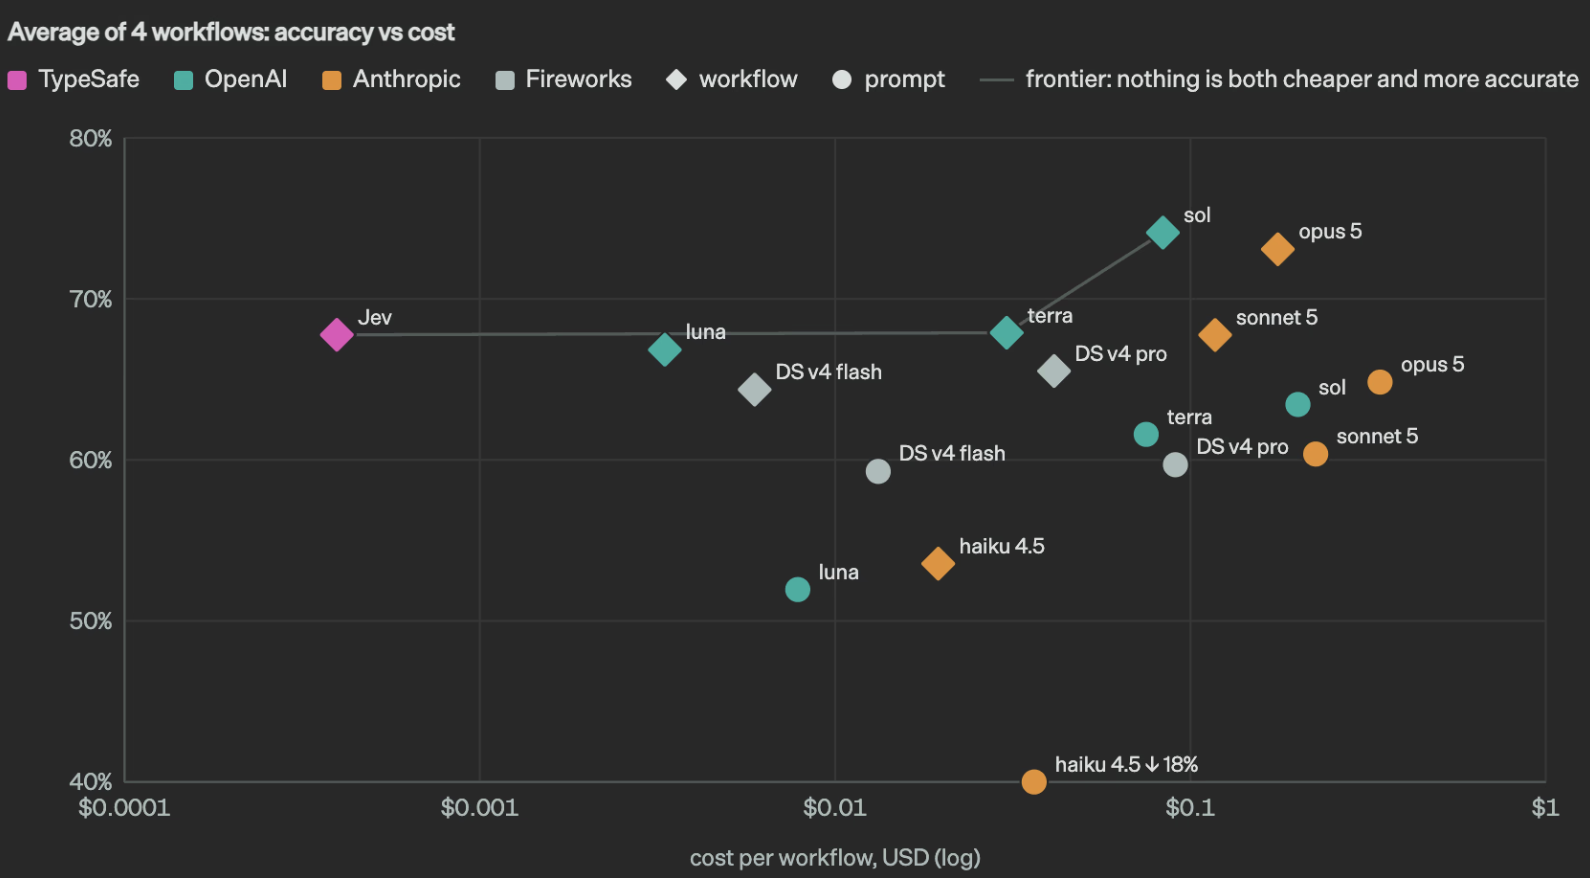
Ці цифри варто сприймати обережно — це заява самої компанії, а не результат незалежної перевірки.
TypeSafe і сама зазначає кілька застережень:
- тести проводили на власних ноутбуках у США;
- компанія не може довести, що низькі ціни не тримаються на тимчасових дотаціях;
- робочі процеси для тестування хоч і не входили до навчальних даних моделі, але їх готувала та сама команда, яка модель розробляла;
- еталоном «правильної» відповіді в тестах слугує середнє значення від двох інших моделей — GPT-6 Astra та Fable 5.1, а це наперед дає перевагу саме їм.
Модель Jev не пише текст, а одразу повертає готове рішення з оцінкою ймовірності — і саме в цьому її головна відмінність від GPT та інших LLM, чиї відповіді потрібно спершу прочитати й перевірити.
Завдяки цьому Jev добре підходить для масових однотипних рішень: сортування звернень, модерації, класифікації, оцінювання. А от для написання текстів, розгорнутих пояснень чи розмови вона не призначена — тут, як і раніше, краще підходять звичайні мовні моделі.
При цьому заявлені показники швидкості й вартості поки що ґрунтуються на тестах самої компанії, тому остаточних висновків про них робити зарано.