Попри те що за останні роки ШІ-моделі почали видавати набагато різноманітніші знання про світ, жодна з них досі не дотягує до звичайного пошуку Google: перші 40 сторінок видачі дають ширший спектр фактів і думок, ніж найкраща модель. Окрім того, великі моделі відповідають одноманітніше за малі, а про події в інших країнах ШІ розповідає переважно так, як їх описують англійською.
До таких висновків дійшли науковці Копенгагенського університету, Стенфорда та ще трьох університетів. Вони проаналізували 27 моделей від OpenAI, Google, Meta та Alibaba, 1,7 млн відповідей на 155 тем і 70 млн окремих тверджень у цих відповідях. Це перше системне дослідження того, як різноманіття знань ШІ змінюється з часом і залежно від країни.
Чому вчених турбує одноманітність відповідей ШІ
Люди дедалі частіше використовують мовні моделі, щоб писати тексти, стискати документи й шукати інформацію. Пошуковики виводять на перше місце ШІ-огляди замість списку сайтів, а дослідники припускають, що незабаром більшість знань ми отримуватимемо саме через посередника-ШІ.
Проблема в тому, що відповіді моделей схожі між собою: вони пишуть в обмеженому наборі стилів, користуються вузьким словником і транслюють схожі думки. Звідси ризик, який економіст Ендрю Пітерсон назвав колапсом знань — ситуація, коли доступ до всього розмаїття людських знань дедалі більше проходить через дедалі вужчу добірку поглядів.
Автори дослідження ввели поняття епістемічного різноманіття — це різноманіття тверджень про світ, які модель видає у відповідях. Чим воно вище, тим ширший спектр фактів, інтерпретацій і поглядів отримує користувач.
Попередні роботи вже фіксували, що різноманіття ШІ низьке. Але їх проводили в одній точці часу, без еталону для порівняння і без урахування того, про яку країну йдеться. Нове дослідження закриває ці прогалини: воно порівнює моделі за роками, з пошуком і за країнами.
Як рахували різноманіття знань
Науковці взяли 27 моделей чотирьох сімейств: Llama від Meta, Gemma від Google, Qwen від Alibaba та GPT від OpenAI — від GPT-3.5 Turbo до GPT-5. Моделі вийшли між кінцем 2022 і 2025 роком, їхній розмір — від 1 до 72 млрд параметрів.
Кожній моделі ставили запитання щодо 155 тем. Тридцять із них загальні: демократія, свобода слова, штучний інтелект, зміна клімату, капіталізм. Решта стосуються конкретних країн — історичних подій і відомих людей США, Аргентини, Ефіопії, Південної Кореї, Франції, Індії, Саудівської Аравії, ПАР, Бразилії, Китаю, Німеччини та інших. Для кожної теми використали 200 шаблонів запитів, написаних людьми, — від «напиши есе про…» до інших прохань розповісти про тему.
Далі кожну відповідь розбили на окремі твердження, а твердження з однаковим змістом об’єднали в групи. Так фраза «Берлінський мур упав 1989 року» рахується як одне знання, хоч би якими словами модель його сформулювала.
Різноманіття оцінили за індексом Гілла — Шеннона. Його використовують в екології, щоб рахувати різноманіття видів. Якщо індекс моделі дорівнює 1000, вона видає стільки ж різних тверджень, скільки модель, яка з однаковою ймовірністю називає один із 1000 різних фактів. Модель з удвічі вищим індексом — удвічі різноманітніша.
Моделі тестували у двох режимах:
- на власних знаннях, тобто лише на тому, що модель засвоїла під час навчання;
- з RAG (retrieval-augmented generation) — коли модель перед відповіддю отримує фрагменти з 20 перших результатів пошуку Google на тему.
Еталоном для порівняння стали перші 40 сторінок пошуку Google за кожною темою. Автори наголошують, що це слабкий еталон: у пошук вводили лише назву теми, тож справжній розрив між пошуком і ШІ може бути ще більшим.
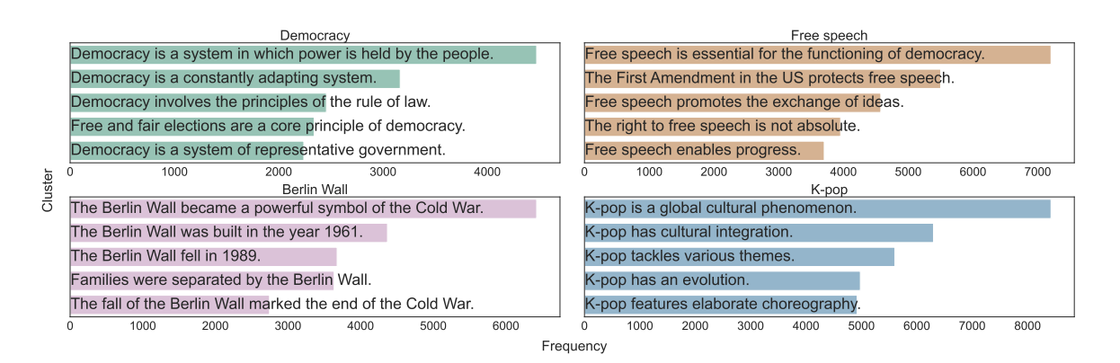
Найчастіші твердження в усіх моделях виявилися загальними фразами. Про Берлінський мур — що він став символом холодної війни, про K-pop — що це глобальний культурний феномен. Уже п’яте за популярністю твердження трапляється вдвічі рідше за перше.
Нові моделі різноманітніші, але пошук досі попереду
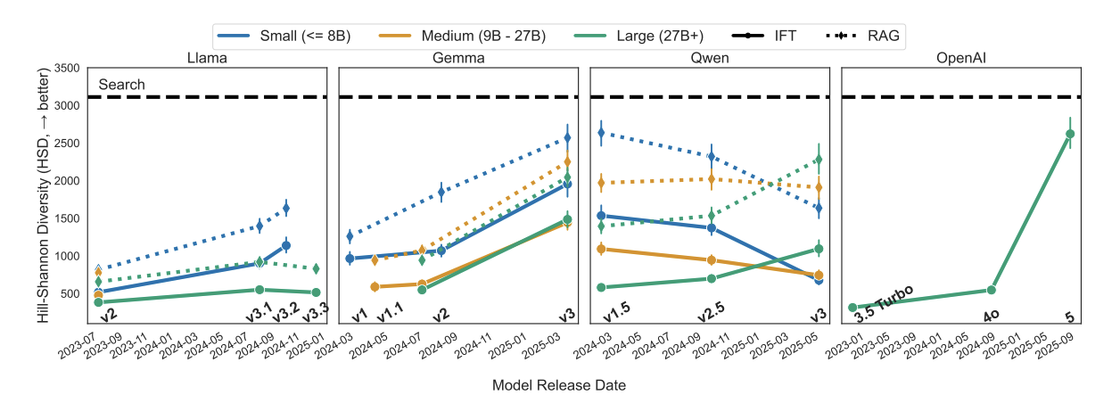
У трьох із чотирьох сімейств моделей різноманіття знань з кожною новою версією зростає. Виняток — Qwen: у його нових версіях показники загалом не покращилися. Найбільший стрибок зробили Gemma 3 і GPT-5. Ефективне різноманіття тверджень у GPT-5 більш ніж уп’ятеро вище, ніж у GPT-4o.
Це суперечить поширеній думці, що ШІ або стоїть на місці, або дедалі більше звужує картину світу. Автори вважають, що нові розробки моделей реально працюють для підвищення різноманіття.
Втім, кожна з 27 моделей поступається пошуку Google. Навіть найкраща, GPT-5, видає щонайменше на 18,7% не такі різноманітні твердження, ніж перші 40 сторінок видачі. Інакше кажучи, людина, яка прочитає кілька сайтів з пошуку, побачить ширший спектр інформації, ніж та, що поставить ШІ ту саму тему в різних формулюваннях.
Цей розрив автори називають тривожним, бо пошуковики дедалі більше переходять на відповіді, згенеровані ШІ. Якщо ШІ витіснить звичний пошук, а розрив збережеться, користувачі матимуть доступ до вужчого кола знань.
Пошукові дані допомагають, а більший розмір моделі — ні
Режим RAG статистично значуще підвищує різноманіття. Коли модель відповідає лише на основі власних знань, її індекс у середньому становить близько 940. З підключеними результатами пошуку він зростає приблизно на 660 пунктів, тобто майже на 70%. Пошук Google без ШІ дає ще на 2 170 пунктів більше за модель без RAG.
Автори застерігають: ця перевага тримається на тому, що сторінки, з яких модель бере дані, написали люди. Якщо інтернет і бази знань для RAG заповнить текст, згенерований ШІ, виграш у різноманітті може зникнути. Тому дослідники радять стежити, щоб у таких базах залишалося різноманіття джерел і було обмежено частку ШІ-контенту.
Друга знахідка суперечить інтуїції: чим більша модель, тим одноманітніші її відповіді. Якщо взяти середні моделі (9–27 млрд параметрів) за точку відліку, малі (до 8 млрд) показують на 24% вищий індекс, а великі (від 27 млрд) — на 20% нижчий. Ефект статистично значущий і збігається з висновками інших сучасних робіт.
Автори пояснюють це тим, що великі моделі більше запам’ятовують із навчальних даних. Через це на однакові запити вони частіше відтворюють ті самі формулювання і факти. Вища якість великих моделей може мати свою ціну — вужчий спектр знань, які вони видають.
ШІ знає світ переважно в англомовній версії
Загальні цифри можуть приховувати нерівність, тому автори окремо перевірили, чиї знання відтворюють моделі.
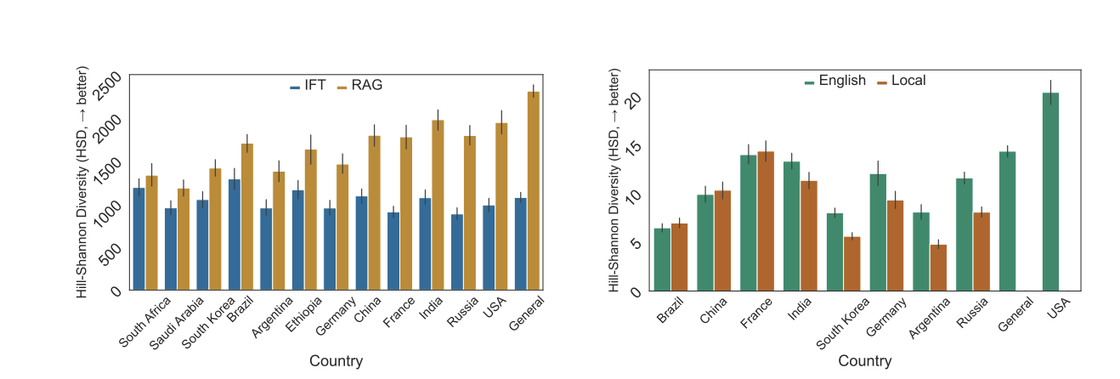
Коли моделі відповідають на основі власних знань, країна теми майже не впливає на різноманіття. Винятки — теми про Ефіопію, Саудівську Аравію та Бразилію: тут показники вищі. А от RAG допомагає країнам нерівномірно. Найбільший приріст отримують теми про США, Індію, Францію, Китай, росію і загальні теми.
Причина, найімовірніше, у джерелах. Пошук для RAG робили з регіону США, тож видача могла гірше охоплювати місцеву інформацію про інші країни. Це підтверджує кореляція 0,73: чим різноманітніша пошукова видача на теми певної країни, тим більше RAG покращує відповіді про неї.
Далі науковці порівняли твердження моделей зі статтями Вікіпедії англійською та місцевою мовою для восьми країн: Бразилії, Китаю, Франції, Індії, Південної Кореї та інших. Запити до моделей ставили англійською.
У п’яти з восьми країн моделі статистично значуще частіше відтворювали англомовну версію знань, ніж місцеву. Протилежного результату — коли місцевої версії більше — не було в жодній країні. Найповніше моделі відтворюють знання про теми, пов’язані з США.
На практиці це означає: людина, яка англійською запитає ШІ про подію в Аргентині чи Індії, імовірніше отримає відповідь у тому вигляді, в якому цю подію описують англійською, а не в тому, як її розуміють і документують місцеві. Автори бачать у цьому ризик витіснення знань, які не були перекладені англійською.
Що варто враховувати
Автори вказують, що теми частково добирали вручну, а для деяких країн — з погляду людей, які не є їхніми жителями. Країну визначали на рівні всієї країни, без поділу на спільноти. Нішеві теми, про які мало пишуть у Вікіпедії, до дослідження не потрапили.
Автоматичне розбиття відповідей на твердження та їх групування працюють якісно, але не ідеально, тож у результатах є певна похибка. Режим RAG налаштували в одному варіанті, а реальні системи влаштовані по-різному.
Окрім того, що різноманіття не дорівнює точності. Дослідження вимірювало, наскільки широкий спектр тверджень видають моделі, а не те, чи ці твердження правдиві.
Прогрес є, але ШІ поки не замінить пошук як джерело знань
Песимізм щодо одноманітності ШІ виявився перебільшеним: нові моделі видають помітно ширший спектр знань, ніж три роки тому. Проте цього прогресу недостатньо, і розподілений він нерівномірно.
Для користувачів висновок простий: покладаючись на ШІ як на головне джерело інформації, ви отримуєте вужчу картину, ніж дав би звичайний пошук. Для розробників — збільшення моделі само по собі не робить її відповіді різноманітнішими і навіть може їм шкодити. Натомість RAG з різноманітними джерелами, написаними людьми, помітно розширює спектр знань.
Окремий виклик — представленість різних країн. Моделі відтворюють переважно англомовну версію знань про світ. Автори закликають вимірювати й покращувати різноманіття не абстрактно, а з огляду на конкретні спільноти, які користуються ШІ.